不用会拍,也能出一条氛围感带货视频
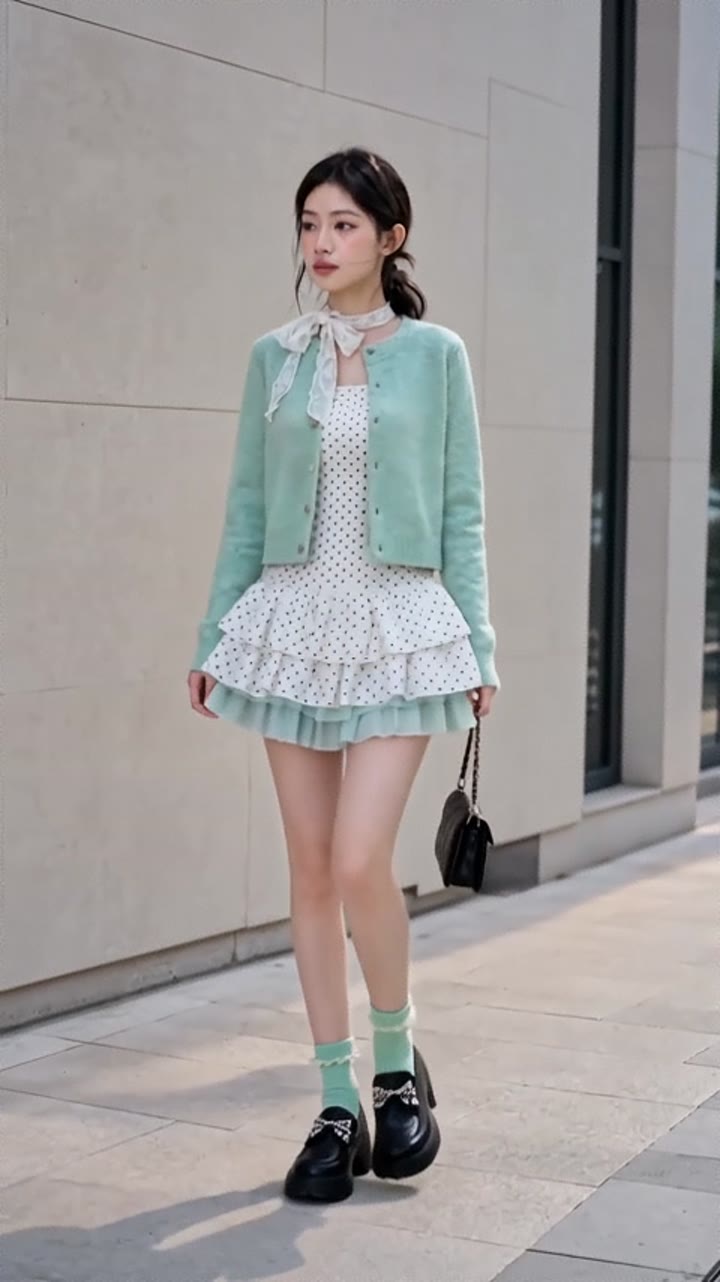
先看跑出来的这条。12 秒、竖屏,模特穿着货走在商圈里,声音也配好了,直接能发:
这篇你能拿走什么
- 一条 12 秒带货视频该怎么拍:多长、切几刀、画面停多久
这些数是 30 条爆款一条条数出来的
- 一个反直觉的规律:让人看下去的关键是"画面停住",但停太久反而没人看
- 完整的做法和参数,可以直接抄
- 跑的时候最容易卡在哪、卡住怎么过,提前告诉你
一句话说清这条片子
不做广告片,做像街拍一样的 12 秒短片:模特穿着你的货走在商圈里,声音配好,直接能发。
它和"让 AI 随便出条视频"的区别只有一个:节奏。
先数一数:爆款到底长什么样
把 30 条同类爆款(衣服带货短片)一条条拆开数,平均数是这样的:
| 看什么 | 平均数 | 大概范围 |
|---|---|---|
| 一条多长 | 12.1 秒 | 10~18 秒 |
| 一共切几刀 | 11.3 次 | 4~23 次 |
| 每个画面停多久 | 1.23 秒 | — |
| 音乐多快 | 每分钟 121 拍 | 30 条里有 16 条在 100~130 拍之间 |
| 画面切换踩不踩鼓点 | 大部分都踩得上 | — |
| 穿什么 | 颜色淡淡的素色,配牛仔或棒球帽,一条里不超过 3 种颜色 | — |
| 怎么拍 | 侧面跟着拍、拍到全身、白天自然光、就在那一片商圈 | — |
先记住这几个数:12 秒左右、切十刀上下、音乐一百二十拍出头。这就是这类片子的基本盘。
★ 规律一:让人看下去的是"画面停住"
怎么验证:每秒截一张图,看画面到底动没动(用眼睛看视频是看不准的)。
30 条数下来的结果:
| 画面完全不动的时间 | 占了快一半(44.7%) |
|---|---|
| 有多少条会停住画面 | 30 条里 30 条都停过 |
| 一条里停几次 | 平均 6.9 次 |
| 每次停多久 | 0.74 秒(不到 1 秒) |
| 停在哪一段 | 前半段只占 18%,后半段占 82% |
说人话:这类片子的节奏不是"一路动到底"。它是 动 → 啪,停住 → 又动 → 啪,又停住。
而且绝大部分"停住"都放在后半段。
反过来看:一条全程匀速在动的片子,画面不动的时间就是 0%。它看着挺干净、模特也在走,但就是"少了那种感觉"。 因为它是一条普通的展示片,不是让人想看完的东西。
★ 规律二:但停太久反而没人看
这条更重要,别矫枉过正:
- 有 4 条是全程不动(跟放图片轮播似的),赞数都很低,只有 494 到 1972
- 赞数最高的两条,画面不动的时间只占 29.6% 和 26.8%
所以目标不是"把视频做静",而是动一动、停一下,停的部分占三成左右。
全停 = 没人看。
怎么做出这种节奏:一条 9 步的做法
第 1 步  上传你的产品图(必须有)
第 2 步  模特参考图(可传可不传)
第 3 步  场景参考图(可传可不传,没有就让它自己编一个)
第 4 步  背景音乐(可传可不传)
             ↓
第 5 步  把这件货写清楚:什么款式、什么颜色、哪些地方绝对不许改
             ↓
第 6 步  把模特和场景也写清楚(传了图就用你的图,没传就让它自己编)
             ↓
第 7 步  先出一张"定妆图":模特穿上你的货,站在场景里,手机竖屏全身
             ↓
第 8 步  写分镜:这 12 秒里,每一秒拍什么、镜头怎么动
             ↓
第 9 步  出成片:手机竖屏,12 秒,带声音
两个关键设计(照做就行)
- 先出一张定妆图,再让它动,别直接让 AI 生成视频。这样你的衣服在第一帧就被定死了,后面只是让它动,衣服被改样的概率小很多。
- 出视频那一步只喂 3 样东西:定妆图、文字要求、音乐。
你的产品图不要塞进去 —— 参考图给太多反而互相打架,不是越多越好。
参数在这,可以直接抄
| 哪一步 | 怎么设 |
|---|---|
| 第 7 步 定妆图 | 手机竖屏(就是刷抖音那种 9:16),拍全身,模特穿这件货站在场景里 |
| 第 8 步 分镜 | 排 12 秒;后半段必须安排几段完全不动的画面(彻底定住,不是慢动作),加起来最好 5 秒以上 |
| 第 9 步 成片 | 竖屏 9:16,12 秒,开声音 |
| 清晰度 | 可以选。够用就行选低档(480×854),要更清楚就往上调 |
| 穿搭要求 | 颜色淡淡的素色,一条里别超过 3 种颜色 |
完整的细节提示词,在无限画布里查
上面那张表是参数。真正的写法都在提示词里 —— 每一句怎么约束、怎么把衣服钉死不跑样、12 秒怎么排,都在里面。这些都放在无限画布里了,登录后随时查阅:
① 登录后打开「无限画布」→ 左上角点「模版」
② 打开「氛围感带货视频工作流」
③ 里面 5 个框有提示词(框左上角的①⑦⑧这些数字,就是模版第几个框),点开任何一个就能复制:
   ·「⑤ 产品分析·锁货」     —— 怎么把衣服钉死,不让它跑样
   ·「⑥ 模特·场景档案」     —— 怎么把模特和场景定下来
   ·「⑦ 定妆首帧」          —— 先出一张定妆图的要求
   ·「⑧ 街拍分镜脚本」      —— 最长的一份,一千多字:12 秒怎么分段、停在哪
   ·「⑨ 成片·12秒街拍快剪」 —— 发给视频模型的最终要求
为什么文章里不贴全文? 因为它跟你的货绑死了 —— 款式、颜色、场景都得换成你自己的。在无限画布里打开,改几个字就能跑;贴在这里,你还得自己拼参数。
跑的时候会遇到什么(提前知道不慌)
① 中间挂掉是常事。 重跑一次,或者换个模型,基本就过了 —— 别以为是自己哪里写错了。
② 最容易卡的是"定妆图"这一步。 这一步不过,后面都别开始。多试两次;实在出不来就换个模型试。
③ 你的要求可能没生效 —— 这是最坑的一条。
如果你把要求写成参数列表或者一大串数据格式,AI 收到的可能跟你以为的不一样。 结果就是"我明明写了,它就是不照做"。
做法:把要求写成一段完整的人话,200 到 400 字,连着写。 开头写明"竖屏,12 秒",别用列表和数据格式。
写完怎么检查它到底生效没有:看成品里画面有没有真的停住。光用眼睛看不准 —— 每秒截一张图,看有没有连续几张长得一模一样。有,说明要求生效了;没有,回去改。
现在的边界(不吹)
- 做不到"后半段连着停五次"。把要求写对之后,"画面停住"能做到**(实测做到过 1.8 秒)。
但离爆款的 44.7% 还差得远。这不是参数没调好,是现在 AI 视频模型的水平就到这儿。
- 踩鼓点只能做到大概对得上(快一点、慢一点、情绪对),做不到人工剪辑那种一刀一个准。
- 切几刀、每一刀多长,AI 自己定。 你只能提要求,不能精确指定。
想要"后半段真的连着停五段",现在只有一个办法。 让 AI 只负责动的那些段,停的部分直接用图片,再用工具把图和视频拼起来。 那是另一件事,这里不展开。
你可以怎么抄(嫌麻烦就看这三条)
- 先出一张定妆图,把你的货和模特定死,再让它动。
- 明确写"后半段要有完全不动的画面"。写清楚是彻底定住、不是慢动作,加起来最好 5 秒以上。
- 成片出来检查画面有没有停住 —— 每秒截一张图看,别凭眼睛。
下一步
想把自己这套流程存下来、下次不用重搭,去看《存一次,以后同样的活点一下就出》。
跑不通,或者你的类目跑出来不是这么回事,加我微信 Chun004720(备注「学习中心」)。 我也想知道它在哪些品类上不灵。