同城口播视频,不用请人拍,一张照片就够
先看跑出来的这条。24 秒、竖屏,看着就是老板本人在店里举着手机跟你说:
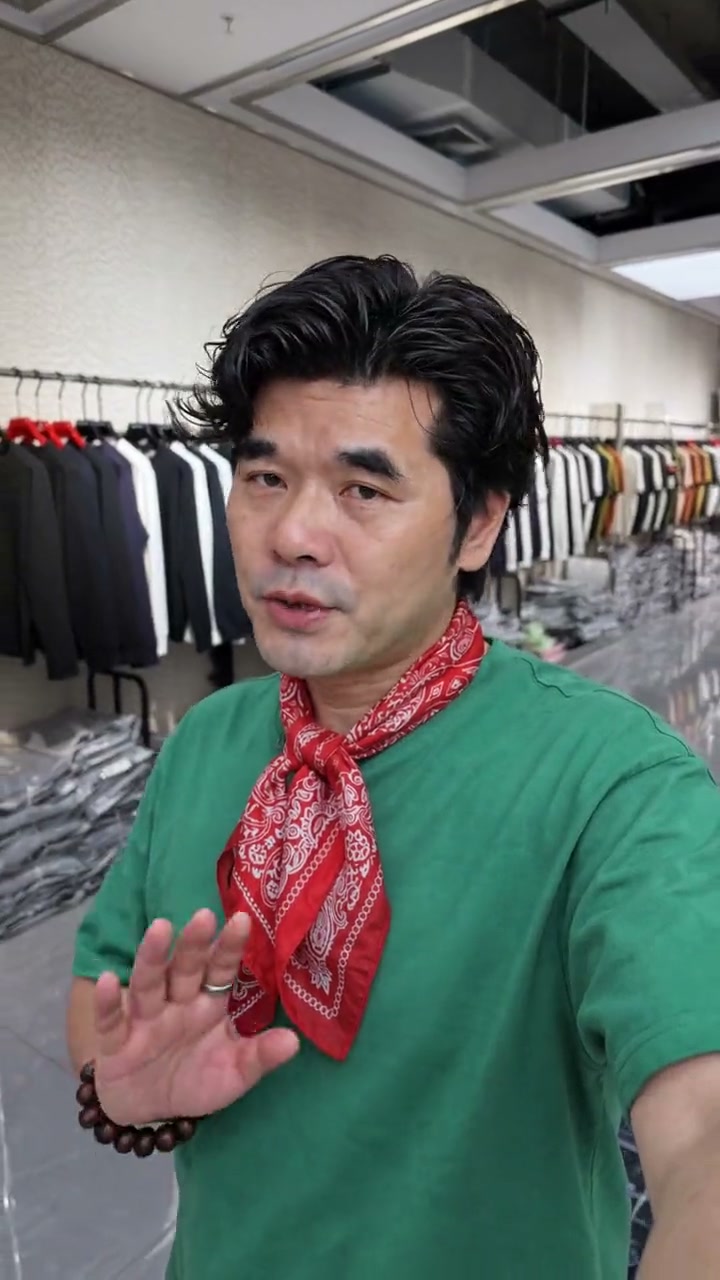
这篇你能拿走什么
- 一条 24 秒口播视频要准备什么:几句话够说、几张图够用
- "看起来像老板自己举着手机拍的"——这种镜头该怎么写,完整写法在下面,可以直接抄
- 怎么让视频里一直是你本人:只丢一张正面照最容易翻车——人脸发糊、前后像两个人。
正确做法是先拿到"人物三视图",下面细说
- 两个容易白跑的地方:秒数别留「自动」;镜头要求里写"手机可以入画",模型就真把手机画出来
什么情况用得上
开实体店的,想让附近的人刷到你、愿意走进来看看。
常见的做法是请人拍,或者自己架个手机一遍遍地重拍——费钱、费时间,还得对着镜头不结巴。
只要给一张正面照、几张店里的照片、一段要说的话。出来的就是"老板本人在店里举着手机跟你说"的样子,24 秒,带声音。
你实际只做三件事
| 你要做的 | 说明 |
|---|---|
| 传一张老板形象照 | 正面、清楚、看得清五官(必填) |
| 传店里的实拍图 | 货架、前台、试衣区都行。传几张就换几个场景(至少 1 张,最多 5 张) |
| 把要说的话粘进去 | 平时怎么跟客人说话就怎么写。95 字以内就够说 30 秒 |
还有一件可选的:录 5~15 秒他说话的声音。录了,AI 就用他自己的音色念台词;不录,就用普通声音念。
剩下的它自己走
模版里一共有 11 个环节,你要碰的只有前 3 个:
你:传老板形象照
你:传店内实拍图(1~5 张)
你:粘口播文案(≤95 字)
          ↓
自动:出一张老板的三视图(正面 / 侧面,用来锁住长相)
          ↓
自动:写拍摄要求(哪一段说什么、镜头怎么摆、背景用哪张店内图)
          ↓
自动:出成片(竖屏、带声音、全部台词念完)
最后那步只喂 3 样东西:写好的拍摄要求、店内图、声音。你拍的那张形象照不会塞进去——参考图给太多反而打架,这点和另一条视频一样的道理。
让视频里一直是你本人(这一步最容易被跳过)
最常见的做法,也是翻车最多的做法:随手传一张正面照,直接出片。
出来的结果往往是:脸有点糊、五官在几段之间飘来飘去,第一段像你、第二段就不太像了。因为模型手里只有一张正面照,侧过脸、换个角度它就得自己猜。
正确做法是先把这张人物参考图做出来,再拿去出片:
你的形象照(1~2 张)
        ↓
自动生成「人物三视图」——四个角度排在同一张图上:
  ① 正面半身   ② 3/4 微侧面   ③ 正侧面   ④ 脸部特写
        ↓
这份参考图锁住"你长什么样",后面每一段都照着它画
        ↓
成片:全片同一个人、同一身衣服四个角度摆在一起,是为了让模型在每个角度都有依据,不用靠猜。所以侧脸、低头、转身这些小变化才不会让你"变成另一个人"。
怎么做更稳(这一步值得多花两分钟):
- 形象照要正面、半身、单人、光线清楚,不遮脸、不戴墨镜口罩
- 有侧面照就一起传进去(第二个角度),三视图会更准
- 照片糊、光线怪、脸上有阴影 → 出来的三视图跟着糊,全片都会受影响
- 拿到三视图先自己看一眼:四个角度是不是同一个人、像不像你。不像就重做这一步,别急着出片
> 一句话记:人物一致性不是出片那一步决定的,是做参考图这一步决定的。
参数在这,可以直接抄
| 要定的事 | 怎么定 |
|---|---|
| 说多久 | 字数 ÷ 3.3 + 1 秒。95 字大约 30 秒,最长就 30 秒,超了就拆成两条 |
| 分几段 | 你传了几张店内图,就分几段。一张图管一段,不能重复用、不能漏 |
| 镜头 | 老板本人举着手机自拍、全程半身(头顶到腰胯)、手机离人一臂远(60~80 厘米)、正面平视 |
| 像什么拍的 | 手机前置镜头(广角)、原相机直出、不要背景虚化、不要美颜磨皮 |
| 段与段之间 | 硬切(画面瞬间跳过去)。不能渐变、不能溶图、不能慢慢变形换场景 |
| 成片 | 竖屏(9:16)、带声音、台词一个字都不能少 |
可以直接抄走的一段
写拍摄要求的时候,把下面这段原样放进去(这是最关键的部分):
画面为老板本人手持手机的前置镜头自拍,全程半身(头顶到腰胯,头顶留约 1/10 画面高度)。
手机前置广角、举机距离约一臂(60-80cm)、与视线齐平正面平视。
手机原相机直出质感:真实皮肤纹理、可见毛孔、轻微面部不对称,
无背景大光圈虚化,允许轻微水平倾斜,手臂持机的自然晃动与呼吸起伏。
限制:手机与持机的手全程不出现(都在画面外),仅持机一侧的上臂与部分小臂自然入画;
另一只手做自然手势;禁全身、禁远景、禁大特写;
禁第三人视角、第二机位、摄影师跟拍、旁人代拍;
禁拍摄者的手臂或影子从画面外侧伸入;禁磨皮美颜、禁蜡像感、禁影棚打光。
完整的细节提示词,在无限画布里查
骨架就是下面这四段。真正跑起来用的完整版都放在无限画布里了,登录后随时查阅。 里面有台词时间线、音色引用、逐段一致性锁这些细节:
① 登录后打开「无限画布」→ 左上角点「模版」
② 打开「同城数字人口播·自拍半身引流」
③ 里面有两处能看提示词(框左上角的⑦⑧,是模版里第几个框):
   ·「⑦ 口播导演」框 —— 管"怎么把文案排成一条完整口播"
   ·「⑧ 成片」框   —— 管"发给视频模型的最终要求"
点开就能看到,直接复制出来用四段长这样(下面是可以抄的骨架):
上面那段是"限制"部分。流程里真正发给视频模型的,是下面这四段拼起来的完整版本。 结构是固定的,"限制"那段的原文就是上面那段:
【主体】<你的形象照>锁定五官/发型/体型/服装,全片同一人、同一身衣服;
       画面为本人手持手机的前置镜头自拍(机位就是他本人举机的位置,全程半身)

【风格】真人实拍的真实手机自拍质感(原相机直出):皮肤有真实纹理与可见毛孔、
       轻微面部不对称、自然光泽;手机前置广角(等效 24mm)、竖屏 9:16;
       举机距离约一臂(60-80cm);无背景大光圈虚化;允许轻微水平倾斜

【时间线】段首写「分段拍摄、段间硬切,每段内场景固定不变」,再逐段写:
       0-8 秒(拍法:手持自拍·半身·固定距离),<动作+幅度+结束状态>,场景=第 1 张店内图;
       用<情绪 / 语调 / 语速>说:"该段台词原文"

【限制】手机与持机的手全程不出现;仅持机一侧上臂与部分小臂自然入画;
       全程半身;禁全身、禁远景、禁大特写;禁第三人视角、第二机位、跟拍;
禁磨皮美颜、禁蜡像感、禁影棚打光;无字幕,台词一字不改完整念出四段缺哪段都会出问题:只写"风格"不写"限制",模型就会把手机画出来;只写"时间线"不写"主体",人脸就会飘。
换成别的视频工具跑,效果会有差别。但这四段的活不能省 —— 它管的是"不跑偏",不是"更好看"。
一个白跑的地方:秒数别留「自动」
我第一次跑的时候,秒数那栏留了「自动」。出来的成片只有 5 秒,24 秒的台词硬塞进去,话说得又急又赶。
更麻烦的是:写拍摄要求的时候是按 24 秒编的三段(0-8 / 8-16 / 16-24)。要求说 24 秒,视频只给 5 秒,模型收到的是自相矛盾的东西。 所以那一次不光短,镜头也乱。
怎么做:秒数那栏直接手填,别用自动。
要填的秒数 = 台词字数 ÷ 3.3 + 1
(95 字 → 约 30 秒,刚好卡在上限)填多少就出多少。这一步花十秒,能省掉一次白跑。
第二个白跑的地方:镜头要求里别写"手机可以入画"
这个坑更值得说,因为它反直觉。
一开始我写的要求比较宽松,想着"自拍嘛,画面里有个手机的边角也正常"。结果模型抓住这句话,把拍摄的手机、举手机的手都画进了画面。看起来像对镜自拍,也像有个人在旁边举着机器拍。 那种一眼假的"摆拍感"就出来了。
后来我拿真人的自拍视频对着看才想明白:
"自拍视角"和"手机不入画"本来是一对矛盾。真实生活中,你举着手机拍自己,手机当然在画面外。可模型不知道这个常识,它反而想把拍摄的工具画出来,来证明这确实是自拍。你只要松一句口,它就往那个方向跑。
所以这条必须反着写死:手机与持机的手全程不出现,只在画面外侧留一点上臂和部分小臂。 这样看起来才像"人举着手机",而不是"对着镜子"。
我上面那段可以抄的写法里,这几句就是专门治这个的。
现在的边界(不吹)
- 30 秒是硬上限。 想说的多,就拆成两条,不要硬塞
- 台词说多快有物理限制。 大概 3.3 字/秒(含停顿)。95 字以上就别指望 30 秒说完
- 场景数由你传的店内图决定。 只传 1 张,整条就一个背景;想有"走遍全店"的感觉,就多拍几张
- 长相靠那张形象照锁。 形象照拍得糊、光线怪,出来的效果就打折——这一步值得多花两分钟
你可以怎么抄(嫌麻烦就看这三条)
- 准备三样:一张清楚的正面照、3~5 张店内实拍、95 字以内的口语化台词
- 秒数手填,别用自动:字数 ÷ 3.3 + 1,几秒就填几
- 镜头要求里把"手机不入画"写死:这是这条视频像不像真人自拍的分界线
下一步
想把这条流程存下来、以后换一批货直接用,去看《存一次,以后同样的活点一下就出》。
跑出来的效果不像你本人,加我微信 Chun004720(备注「学习中心」)。 台词时间总不够、或者别的类目上不灵,也欢迎告诉我。